Activity
Mon
Wed
Fri
Sun
Oct
Nov
Dec
Jan
Feb
Mar
Apr
May
Jun
Jul
Aug
Sep
What is this?
Less
More
Prompt Models Academy
622 members • Free
Miguel Urteaga
646 members • Free
COPA AI | Pilas Academy
9.3k members • $1/month
Empresarios Digitales
27.5k members • Free
Escala Tu Expertise
2.2k members • Free
NOS MUDAMOS
3.1k members • Free
Club Power BI
2k members • $3/month
Inmigrantes IA
1.1k members • $17/m
1 contribution to NOS MUDAMOS
Mar 7 •
Idea de Proyecto: Traductor Inteligente de Libros Técnicos (EPUB/PDF) con IA Local y Preservación de Estructura
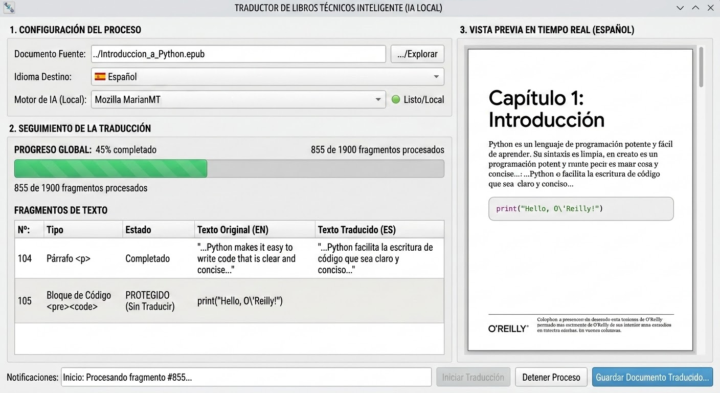
A cuántos les pasa que tienen una joya de libro de O'Reilly o Packt, pero al querer traducirlo con herramientas convencionales el código se rompe, las tablas se deforman y el diseño se vuelve un caos? 😩 He estado investigando a fondo la estructura HTML/CSS de los documentos digitales (basándome en el estándar de visualización de O'Reilly) y tengo una propuesta técnica para solucionar esto de raíz. 🛠️ La Propuesta Técnica: No se trata de "meter el PDF a Google Translate". La idea es crear un Pipeline de Procesamiento Estructurado: 1. Segmentación Semántica: Usar un Parser (BeautifulSoup/lxml) para identificar etiquetas críticas. 2. Aislamiento de Código: Proteger automáticamente bloques <pre>, <code> y clases de diagramas para que la IA NO los toque. El código se queda intacto y funcional. 💻 3. Traducción Local y Ligera: Utilizar modelos "pequeños pero chingones" (como los de Firefox/Bergamot o Argos Translate) para procesar fragmentos de texto de forma local. ¡Privacidad total y 0 costo de API! 🦊 4. UI con PySide6: Una interfaz profesional con barras de progreso reales, procesamiento por hilos (para que no se congele) y una vista previa en tiempo real usando el motor de Chromium. 🎯 El Objetivo: Lograr un libro en español u otro idioma logrando que se vea exactamente igual al original, con las fuentes, márgenes e imágenes en su sitio, pero con el texto traducido de forma limpia y precisa. ¿Qué busco? Más que nada compartir el aporte, pero si a alguien le interesa colaborar en su desarrollo en Python o en el entrenamiento de los modelos locales, ¡comenten! Creo que es una herramienta que nos serviría a todos los que devoramos documentación técnica. Les comparto acerca de la investigación que realice y previsualización. ¿Qué opinan? ¿Le ven futuro? ¡Los leo! 👇
1 like • Apr 14
Wow que excelente proyecto ! Espero lo puedas compartir cuando ya lo tengas finalizado.
1-1 of 1

@julio-yataco-9330
Un ingeniero apasionado por la inteligencia artificial. Con muchas ganas de aprender y ayudar en lo que pueda a la comunidad 😉🙂
Active 73d ago
Joined Nov 24, 2025